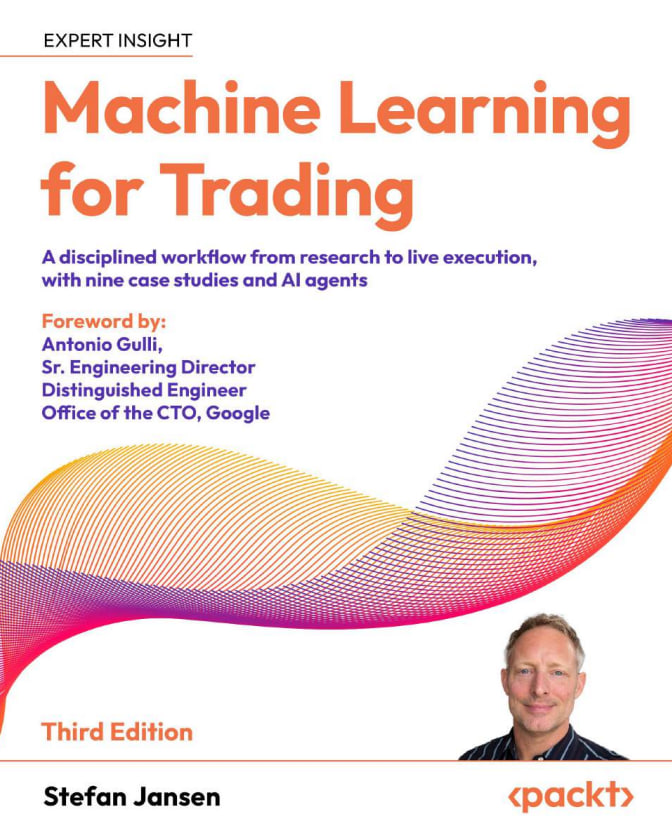
A disciplined workflow from research to live execution, with nine case studies and Al agents
سال چاپ: 2026
تعداد صفحات: 827
ناشر: انتشارات Packt Publishing
زبان: english
نویسنده(گان): Stefan Jansen
دسته بندی: Machine Learning, هوش مصنوعی
نسخه فیزیکی
نسخه الکترونیک
قیمت نهایی: 0 تومان
کتاب یادگیری ماشین برای معاملهگری؛ از پژوهش و ساخت مدل تا استقرار سامانههای معاملاتی
یادگیری ماشین امکانات جدیدی برای معاملهگری سیستماتیک ایجاد کرده است؛ اما همان ابزارهایی که میتوانند یک مزیت واقعی در بازار پیدا کنند، اگر بدون دقت استفاده شوند، میتوانند مزیتی کاملاً ساختگی در نتایج آزمون ایجاد کنند.
این مسئله نقطه شروع کتاب یادگیری ماشین برای معاملهگری است.
هدف کتاب صرفاً آموزش چند الگوریتم یادگیری ماشین یا ساخت یک مدل پیشبینی قیمت نیست. تمرکز اصلی بر ایجاد یک فرایند کامل، منظم و قابل تکرار برای پژوهش، ارزیابی، ساخت و اجرای استراتژیهای معاملاتی مبتنی بر یادگیری ماشین است.
ویرایش سوم کتاب از ابتدا بازطراحی شده و به جای اینکه روشهای مختلف را به صورت جداگانه معرفی کند، یک مسیر کامل را از ابتدا تا انتها دنبال میکند:
زیرساخت داده → پژوهش استراتژی → مهندسی ویژگی → ساخت مدل → آزمون → هزینه و ریسک → استقرار → پایش → بازآموزی یا توقف استراتژی
در مرکز این رویکرد یک ایده مهم قرار دارد:
مزیت اصلی شما فقط مدل نیست؛ فرایندی است که به شما اجازه میدهد بفهمید چه زمانی یک سیگنال واقعی است و چه زمانی فقط نویز بازار را با یک الگوی ظاهراً موفق اشتباه گرفتهاید.
چرا فرایند از مدل مهمتر است؟
یکی از مشکلات رایج در معاملهگری الگوریتمی، پیدا کردن مدلی است که روی دادههای گذشته عملکرد بسیار خوبی دارد.
اما عملکرد خوب در گذشته به تنهایی به معنای وجود یک استراتژی واقعی نیست.
ممکن است پژوهشگر:
دادهها را به شکل نامناسب تقسیم کند.
از اطلاعات آینده به صورت ناخواسته استفاده کند.
تعداد بسیار زیادی فرضیه را آزمایش کند.
مدلی را صرفاً بر اساس نتیجه آزمون انتخاب کند.
هزینههای واقعی معاملات را نادیده بگیرد.
بیش از حد روی دادههای تاریخی برازش ایجاد کند.
در چنین شرایطی ممکن است یک استراتژی در آزمون تاریخی بسیار موفق به نظر برسد، اما در بازار واقعی عملکرد خود را از دست بدهد.
کتاب تلاش میکند دقیقاً با همین مشکل مقابله کند.
یک مدل پیچیده که فقط روی دادههای گذشته عالی عمل میکند، لزوماً مزیت معاملاتی نیست.
در مقابل، یک فرایند پژوهشی منظم میتواند به پژوهشگر کمک کند تا متوجه شود چه زمانی یک سیگنال در حال ضعیف شدن است و چه زمانی باید استراتژی را اصلاح، متوقف یا بازنشسته کرد.
رویکرد یکپارچه ویرایش سوم
ویرایش سوم کتاب بر اساس یک گردش کار یکپارچه طراحی شده است.
در نسخه جدید، نه فصلها و تکنیکها به صورت مجموعهای از روشهای مستقل، بلکه به عنوان بخشهایی از یک سیستم کامل دیده میشوند.
این گردش کار از زیرساخت داده شروع میشود و پس از عبور از یک مرز شواهد، به ارزیابی و سپس استقرار میرسد.
مرز شواهد به تفکیک میان:
کاوش و تنظیم مدل
و
ارزیابی واقعی عملکرد
کلمات کلیدی:
نسخه فیزیکی
نسخه الکترونیک
قیمت نهایی: 0 تومان
کمک میکند.
این تفکیک برای جلوگیری از بیشبرازش و نتیجهگیری نادرست از آزمونهای تاریخی اهمیت زیادی دارد.
نه مطالعه موردی در سراسر کتاب
یکی از ویژگیهای مهم این ویرایش، استفاده از نه مطالعه موردی است که در بخشهای مختلف کتاب ادامه پیدا میکنند.
این مطالعات موردی حوزههای مختلف بازار را پوشش میدهند، از جمله:
این ساختار کمک میکند خواننده فقط یک الگوریتم را یاد نگیرد، بلکه ببیند یک روش یادگیری ماشین چگونه در یک فرایند واقعی معاملهگری قرار میگیرد.
دادههای مالی؛ پایه هر استراتژی
هر سیستم معاملهگری مبتنی بر یادگیری ماشین به داده وابسته است.
اگر داده ناقص، ناسازگار یا دارای خطا باشد، مدل نیز نمیتواند نتیجه قابل اعتمادی ایجاد کند.
دنیای دادههای مالی
فصل دوم مجموعه بزرگی از دادههای بازار، بنیادی و جایگزین را در هشت گروه دارایی بررسی میکند.
موضوعاتی مانند:
ساختار دادههای مالی
کیفیت داده
سوگیری بقا
قالبهای ذخیره سازی
زیرساخت داده
در این بخش مورد توجه قرار میگیرند.
کیفیت داده فقط یک مسئله فنی نیست؛ بخشی از اعتبار کل پژوهش معاملاتی است.
ریزساختار بازار
فصل سوم از پیامهای خام صرافی به دادههای مناسب برای استخراج ویژگی حرکت میکند.
مباحث این بخش شامل:
پردازش پیامهای NASDAQ ITCH
بازسازی دفتر سفارشات محدود
طبقه بندی معاملات
روشهای نمونه برداری از دادههای بازار
ساخت میلههای قیمتی
است.
این موضوعات برای افرادی که قصد دارند از دادههای ریزساختار بازار برای پژوهشهای معاملاتی استفاده کنند اهمیت ویژهای دارند.
دادههای بنیادی و جایگزین
دادههای قیمتی تنها منبع اطلاعات برای مدلهای معاملاتی نیستند.
کتاب در فصل چهارم به ساخت جریانهای دادهای لحظهای برای:
گزارشهای SEC EDGAR
تشخیص و تطبیق موجودیتها
دادههای بنیادی اقتصاد کلان
کالاها
دادههای جایگزین
دادههای زنجیرهای رمزارزها
بازارهای پیشبینی
میپردازد.
هدف این است که اطلاعاتی که در یک زمان مشخص در دسترس بودهاند، به شکل صحیح وارد فرایند پژوهش شوند.
دادههای مالی مصنوعی
وقتی تاریخچه داده محدود باشد، امکان اعتبارسنجی استراتژی میتواند کاهش پیدا کند.
فصل پنجم به تولید دادههای مالی مصنوعی میپردازد و روشهایی مانند:
TimeGAN
Tail-GAN
Sig-CWGAN
مدلهای انتشار
تولید مبتنی بر مدلهای زبانی بزرگ
را بررسی میکند.
این دادهها سپس از منظر:
وفاداری، کاربردپذیری و حریم خصوصی
ارزیابی میشوند.
طراحی پژوهش استراتژی
پیش از ساخت مدل باید مشخص شود دقیقاً چه مسئلهای قرار است حل شود.
فصل ششم چارچوب پژوهش استراتژی را معرفی میکند و مواردی مانند:
قوانین انتخاب داراییها
زمان بندی تصمیمها
مدل هزینه
روش ارزیابی
ثبت اجرای آزمایش
اعتبارسنجی پیشرونده
را مشخص میکند.
مدل نباید قبل از تعریف دقیق بازی معاملاتی ساخته شود.
این رویکرد کمک میکند مسئله پژوهش از ابتدا با شرایط واقعی معاملهگری هماهنگ باشد.
تعریف مسئله یادگیری
فصل هفتم به تبدیل مسئله معاملاتی به مسئله یادگیری میپردازد.
موضوعات اصلی شامل:
مهندسی برچسب
ارزیابی تکمتغیره ویژگیها
ضریب اطلاعات
کنترل آزمونهای متعدد
بررسی امکانپذیری علّی
هستند.
یکی از مسائل مهم این مرحله جلوگیری از نتیجهگیری اشتباه از تعداد زیادی آزمایش است.
اگر صدها یا هزاران فرضیه را امتحان کنید، احتمال اینکه یکی از آنها صرفاً به دلیل تصادف نتیجه خوبی نشان دهد افزایش پیدا میکند.
مهندسی ویژگیهای مالی
فصل هشتم ویژگیهای مختلف مورد استفاده برای مدلهای معاملاتی را میسازد.
این ویژگیها شامل گروههایی بر اساس:
قیمت
ساختار بازار
ارتباط میان ابزارهای مختلف
زمینه و شرایط بازار
هستند.
همچنین انتخاب ویژگی و آزمون استحکام آنها بررسی میشود.
ویژگی خوب فقط ویژگیای نیست که روی دادههای تاریخی نتیجه خوبی ایجاد کند؛ باید در آزمونهای مختلف نیز رفتار قابل اتکایی داشته باشد.
استخراج ویژگی با مدلها
فصل نهم ویژگیهایی را بررسی میکند که از مدلهای برازش شده استخراج میشوند.
از جمله:
فیلترهای کالمن
روشهای طیفی
نوسان پذیری GARCH
احتمال رژیمهای بازار با مدلهای مخفی مارکوف
در تمام این موارد، صحت زمانی دادهها اهمیت دارد.
هدف جلوگیری از استفاده ناخواسته از اطلاعاتی است که در زمان تصمیم گیری واقعی در دسترس نبودهاند.
ویژگیهای متنی و پردازش زبان
اطلاعات متنی نیز میتوانند برای پژوهش مالی مورد استفاده قرار گیرند.
فصل دهم مسیر پردازش متن را از روشهای سادهتر تا مدلهای پیشرفتهتر دنبال میکند:
کیسه واژهها
TF-IDF
تعبیه واژهها
مدلهای دنبالهای
ترنسفورمرها
احساسسنجی مالی با FinBERT
تشخیص موجودیتهای مالی
ارتباط اخبار و بازده
این بخش نشان میدهد چگونه دادههای متنی میتوانند به ویژگیهای قابل استفاده در مدلهای معاملاتی تبدیل شوند.
مدلهای یادگیری ماشین
فصلهای ۱۱ تا ۱۵ مجموعهای از خانوادههای مدل را روی مطالعات موردی یکسان اعمال میکنند.
مدلهای خطی به عنوان خط پایه
فصل یازدهم مدلهای خطی منظمسازی شده را به عنوان خط پایه معرفی میکند.
هر مدل پیشرفتهتر باید بتواند ارزش افزوده خود را نسبت به این خط پایه نشان دهد.
در این فصل همچنین موضوعاتی مانند:
تفسیرپذیری با SHAP
پیشبینی تطبیقی
مقایسه میان مجموعه دادهها
بررسی میشوند.
مدلهای پیشرفته داده جدولی
فصل دوازدهم به مدلهای تقویتی گرادیانی مانند:
XGBoost
LightGBM
CatBoost
میپردازد.
تنظیم چندهدفه مدل، تفسیرپذیری و مقایسه نتایج نیز مورد بررسی قرار میگیرند.
یادگیری عمیق برای سریهای زمانی
فصل سیزدهم معماریهای مختلف یادگیری عمیق برای سری زمانی را بررسی میکند، از جمله:
LSTM
N-BEATS
ترنسفورمرها
TSMixer
TCN
Mamba
همچنین شواهد مربوط به زمانهایی که یادگیری عمیق واقعاً میتواند مفید باشد بررسی میشود.
پیچیدهتر بودن مدل به خودی خود به معنای بهتر بودن استراتژی نیست.
مدلهای عوامل نهفته
فصل چهاردهم به مدلهای عامل نهفته میپردازد.
موضوعاتی مانند:
مؤلفههای اصلی
پرتفویهای ویژه
IPCA
خودرمزگذارهای شرطی
خودرمزگذارهای نظارت شده
برآورد تابع تنزیل تصادفی با روشهای خصمانه
بررسی میشوند.
هدف این است که مشخص شود عوامل نهفته در چه شرایطی میتوانند اطلاعات ارزشمندی برای مدلهای معاملاتی فراهم کنند.
یادگیری ماشین علّی
همبستگی میان دو متغیر لزوماً به معنای وجود رابطه واقعی میان آنها نیست.
این مسئله در معاملهگری الگوریتمی اهمیت زیادی دارد.
فصل پانزدهم از روشهای یادگیری ماشین علّی برای جدا کردن اثر واقعی از همبستگی ساختگی استفاده میکند.
روشهایی مانند:
یادگیری ماشین دوگانه
سری زمانی ساختاری بیزی
کشف روابط علّی
در مطالعات موردی کتاب به کار گرفته میشوند.
شبیه سازی استراتژی و آزمون گذشتهنگر
آزمون گذشتهنگر یکی از حساسترین مراحل پژوهش معاملاتی است.
کتاب آن را صرفاً راهی برای نمایش عملکرد تاریخی نمیداند، بلکه از آن به عنوان ابزاری برای ابطال فرضیه استفاده میکند.
فصل شانزدهم موضوعاتی مانند:
تعریف پروتکل آزمون
موتورهای برداری
موتورهای رویدادمحور
گزارش معیارها
کنترل بیشبرازش در سطح استراتژی
را بررسی میکند.
مشکل بیشبرازش
اگر یک پژوهشگر بارها و بارها مدل و پارامترها را روی دادههای تاریخی تغییر دهد، ممکن است مدل به جای یادگیری ویژگی واقعی بازار، به خود دادههای آزمون عادت کند.
این یکی از خطرناکترین مشکلات پژوهش کمی است.
یک نتیجه عالی در آزمون گذشتهنگر، بدون کنترل فرایند پژوهش، میتواند کاملاً گمراه کننده باشد.
کتاب برای مقابله با این مشکل به روشهایی مانند اعتبارسنجی پیشرونده و کنترل آزمونهای متعدد توجه ویژه دارد.
نسبت شارپ تعدیل شده و پیشبینی همدیس
ویرایش سوم ابزارهای آماری پیشرفتهتری را برای مقابله با نتایج گمراه کننده وارد فرایند میکند.
از جمله:
نسبت شارپ تعدیل شده
پیشبینی همدیس
این روشها کمک میکنند ارزیابی مدل و استراتژی فقط بر اساس یک معیار ساده انجام نشود.
ساخت پرتفوی
پیشبینی مدل به تنهایی یک استراتژی معاملاتی کامل نیست.
باید مشخص شود چگونه این پیشبینیها به موقعیتهای معاملاتی و پرتفوی تبدیل شوند.
فصل هفدهم به موضوعاتی مانند:
بهینه سازی میانگین و واریانس
محدودیتهای آن
برابری سلسله مراتبی ریسک
اندازه گذاری بر اساس معیار کلی
اندازه گذاری موقعیت با پیشبینی همدیس
میپردازد.
هزینه معاملات
یک استراتژی ممکن است روی کاغذ سودآور باشد، اما پس از در نظر گرفتن هزینههای واقعی معامله، مزیت آن از بین برود.
فصل هجدهم به:
انواع هزینه معاملات
اختلاف قیمت خرید و فروش
برآورد اثر بازار
الگوریتمهای اجرا
تحلیل هزینه معاملات
هزینه سر به سر
میپردازد.
استراتژی واقعی باید پس از کسر هزینههای معامله نیز بتواند دوام بیاورد.
مدیریت ریسک
هیچ استراتژی معاملاتی بدون مدیریت ریسک کامل نیست.
فصل نوزدهم مواردی مانند:
ارزش در معرض ریسک
ارزش در معرض ریسک شرطی
کنترل افت سرمایه
تحلیل عوامل
تحلیل بخشهای بازار
آزمون فشار
پوشش ریسک تطبیقی
پوشش ریسک عمیق
کلیدهای توقف اضطراری
را بررسی میکند.
این موضوعات برای تبدیل یک مدل پژوهشی به یک سامانه قابل استفاده در بازار اهمیت اساسی دارند.
ترکیب استراتژی
فصل بیستم نتایج نه آزمایش را در کنار یکدیگر قرار میدهد و بررسی میکند چگونه میتوان پیشبینیهای مدل را به استراتژیهای واقعی تبدیل کرد.
موضوعاتی مانند:
ارتباط ضریب اطلاعات و شارپ
تفاوت میان خانوادههای مدل
تحلیل بقا پس از هزینهها
چارچوب تصمیم گیری برای معاملهگر
در این فصل بررسی میشوند.
یادگیری تقویتی برای معاملهگری
بخش پیشرفته کتاب وارد حوزه یادگیری تقویتی میشود.
فصل بیست و یکم اجرای معاملات و پوشش ریسک را به صورت فرایند تصمیم گیری مارکوف مدل میکند.
روشهایی مانند:
DQN
PPO
SAC
برای موضوعاتی مانند:
اجرای بهینه سفارشها
بازارسازی
پوشش ریسک عمیق
بررسی میشوند.
هوش مصنوعی مولد در پژوهش مالی
یکی از بخشهای جدید و مهم ویرایش سوم، استفاده از هوش مصنوعی مولد در پژوهش مالی است.
فصل بیست و دوم به تولید تقویت شده با بازیابی یا RAG برای پژوهش مالی میپردازد.
این فرایند با اطلاعاتی مانند گزارشهای SEC تغذیه میشود و مراحل زیر را پوشش میدهد:
دریافت و آماده سازی اطلاعات
تعبیههای تخصصی حوزه مالی
بازیابی ترکیبی
ارزیابی
حرکت به سمت جریانهای کاری عامل محور
گرافهای دانش
فصل بیست و سوم به ساخت گرافهای دانش از اطلاعات مالی میپردازد.
موضوعات این فصل شامل:
ساخت گراف دانش
Graph RAG
استدلال چندمرحلهای
ویژگیهای گراف برای یادگیری ماشین
جلوگیری از نشت اطلاعات زمانی
است.
این رویکرد میتواند برای ارتباط دادن اطلاعات پراکنده موجود در اسناد مالی و استخراج روابط پیچیده میان آنها استفاده شود.
عاملهای خودمختار برای پژوهش مالی
فصل بیست و چهارم یک گام فراتر میرود و عاملهای خودمختار را وارد فرایند پژوهش میکند.
مباحثی مانند:
معماری عاملها
حافظه
ابزارها
پشته مهندسی
عامل پژوهش سهام دارای حالت
پیشبینی چندعاملی
مناظره میان عاملها
بررسی میشوند.
در اینجا هوش مصنوعی دیگر فقط یک مدل پیشبینی نیست؛ بلکه میتواند بخشی از فرایند کامل پژوهش مالی باشد.
استقرار در بازار واقعی
پس از پژوهش و آزمون، استراتژی باید بتواند وارد محیط واقعی شود.
فصل بیست و پنجم چارچوبی برای ارتباط میان پژوهش و تولید ارائه میکند و موضوعاتی مانند:
Interactive Brokers
Alpaca
پلتفرمهای مدیریت شده
چرخه عمر سفارش
آمادگی عملیاتی
را بررسی میکند.
این بخش فاصله میان یک دفترچه پژوهشی و یک سامانه معاملاتی واقعی را هدف قرار میدهد.
MLOps و حاکمیت
مدل پس از استقرار نیز به حال خود رها نمیشود.
بازار تغییر میکند، داده تغییر میکند و عملکرد مدل ممکن است به مرور افت کند.
فصل بیست و ششم به زیرساخت عملیاتی مورد نیاز برای نگهداری سامانههای یادگیری ماشین میپردازد.
از جمله:
طبقه بندی خطاهای یادگیری ماشین
تشخیص تغییر توزیع داده
انتشار ایمن
قطع کنندههای مدار
مخازن ویژگی
ثبت آزمایشها
نظارت و بازآموزی استراتژی
یک استراتژی معاملاتی موفق در گذشته لزوماً در آینده نیز موفق باقی نمیماند.
بازارها:
تغییر میکنند.
رژیم عوض میکنند.
ساختارشان تغییر میکند.
برخی سیگنالها را از بین میبرند.
به همین دلیل، سیستم باید بتواند عملکرد استراتژی را پایش کند و در صورت کاهش مزیت، بازآموزی، توقف یا بازنشسته کردن استراتژی را در نظر بگیرد.
این نگاه، معاملهگری الگوریتمی را از ساخت یک مدل یکباره به یک فرایند زنده تبدیل میکند.
کتاب و مخزن کد همراه آن
این کتاب به شکل متفاوتی با کدهای نمونه برخورد میکند.
کدهای کامل در صفحات کتاب چاپ نشدهاند.
در عوض، پیاده سازی کامل روشها، شکلها و نه مطالعه موردی در مخزن کد همراه کتاب قرار دارد.
این تصمیم به دلیل ماهیت متغیر نرم افزار و دادههای معاملاتی گرفته شده است.
کتابها ثابت هستند، اما:
کتابخانهها تغییر میکنند.
منابع داده تغییر میکنند.
خطاهای نرم افزاری کشف میشوند.
ابزارهای جدید منتشر میشوند.
مخزن کد میتواند این تغییرات را در طول زمان دریافت کند.
بنابراین کتاب نقش توضیح مفهوم، منطق و نتایج را دارد و مخزن کد محیط اجرای عملی آنهاست.
یادگیری با دفترچههای تعاملی
هر فصل با یک پوشه مشخص در مخزن همراه است.
هر پوشه شامل راهنمایی است که مشخص میکند:
هدف یادگیری فصل چیست.
هر مفهوم در کدام دفترچه پیاده سازی شده است.
چگونه دفترچه را اجرا کنید.
چه منابع علمی برای مطالعه بیشتر وجود دارد.
دفترچهها نیز در قالب فایلهای جفت شده قرار دارند و امکان ویرایش و اجرای آنها را فراهم میکنند.
بهترین روش استفاده از کتاب این است که هر فصل را بخوانید و سپس همان فصل را با اجرای کدهای مرتبط دنبال کنید.
محیط بازتولیدپذیر
برای اطمینان از بازتولید نتایج، کتاب پیشنهاد میکند محیط کار یک بار تنظیم شود و اجرای پژوهش از محیط مشخصی انجام گیرد.
استفاده از محیطهای کانتینری نیز برای ایجاد شرایط قابل تکرار پیشنهاد شده است.
این مسئله در پژوهشهای یادگیری ماشین اهمیت زیادی دارد؛ زیرا تغییر نسخه کتابخانهها یا تنظیمات محیط میتواند روی نتیجه آزمایش اثر بگذارد.
مطالعه از یک مورد ساده
برای شروع کار با دادهها، مطالعه موردی مربوط به صندوق قابل معامله پیشنهاد میشود.
این مطالعه موردی:
داده رایگان دارد.
به کلید دسترسی ویژه نیاز ندارد.
سریع اجرا میشود.
در نتیجه میتواند یک مسیر ساده برای مشاهده کل فرایند از داده تا استراتژی فراهم کند.
پس از درک جریان کامل، میتوان به دادهها و مطالعات موردی پیچیدهتر رفت.
منابع مکمل
اکوسیستم همراه کتاب فقط به مخزن کد محدود نمیشود.
منابع مکمل شامل:
مطالب مقدماتی مالی و آماری
منابع یادگیری ماشین
مهارتهای عاملهای هوش مصنوعی
صفحه اختصاصی هر فصل
کتابشناسی
توضیحات مطالعات موردی
دورههای آموزشی
مطالب پژوهشی جدید
است.
این منابع برای افرادی که در بعضی مباحث پیش نیاز ضعیفتری دارند نیز کاربرد دارند.
این کتاب برای چه کسانی مناسب است؟
پژوهشگران کمی و معاملهگران
اگر میخواهید از یادگیری ماشین برای ساخت و ارزیابی استراتژیهای معاملاتی استفاده کنید، این کتاب فرایند کامل پژوهش تا استقرار را پوشش میدهد.
دانشمندان داده
اگر دانش علم داده دارید و میخواهید وارد حوزه مالی شوید، کتاب کاربرد مدلهای یادگیری ماشین را در یک محیط واقعیتر نشان میدهد.
مهندسان یادگیری ماشین
موضوعاتی مانند MLOps، استقرار، پایش مدل، تشخیص تغییر توزیع داده و زیرساخت تولید برای مهندسان یادگیری ماشین اهمیت ویژهای دارند.
دانشجویان پیشرفته
برای دانشجویانی که با احتمال، آمار، جبر خطی و پایتون راحت هستند، کتاب میتواند پلی میان یادگیری ماشین و معاملهگری کمی ایجاد کند.
سرمایه گذاران فنی
افرادی که دانش برنامه نویسی دارند و میخواهند ساخت و ارزیابی سیستماتیک استراتژیهای معاملاتی را یاد بگیرند نیز میتوانند از کتاب استفاده کنند.
پیش نیازهای کتاب
برای استفاده بهتر از کتاب، بهتر است با موارد زیر راحت باشید:
برنامه نویسی پایتون
احتمال
آمار
جبر خطی
آشنایی قبلی با یادگیری ماشین و بازارهای مالی مفید است، اما الزامی نیست.
برای شروع لزوماً به سابقه معاملهگری نیاز ندارید؛ اما باید آماده باشید که کد را اجرا کنید و نتایج را بررسی کنید.
جمع بندی
این کتاب درباره پیدا کردن یک مدل جادویی برای پیشبینی بازار نیست.
تمرکز اصلی آن بر ساخت یک فرایند منظم برای تبدیل ایده پژوهشی به یک استراتژی معاملاتی قابل ارزیابی و در نهایت قابل استقرار است.
ویرایش سوم کتاب این مسیر را از دادههای مالی و ریزساختار بازار شروع میکند و سپس به مهندسی ویژگی، طراحی مسئله یادگیری، مدلهای خطی، یادگیری تقویتی گرادیانی، یادگیری عمیق، مدلهای عوامل نهفته و یادگیری ماشین علّی میرسد.
در مرحله بعد، پیشبینیها به استراتژی، پرتفوی و معاملات واقعی تبدیل میشوند و موضوعاتی مانند آزمون گذشتهنگر، بیشبرازش، هزینه معاملات، مدیریت ریسک و اجرای سفارش بررسی میشوند.
در بخشهای پیشرفتهتر، کتاب سراغ یادگیری تقویتی، هوش مصنوعی مولد، RAG، گرافهای دانش و عاملهای خودمختار برای پژوهش مالی میرود.
در نهایت، مسیر با استقرار واقعی، MLOps، پایش تغییرات و حاکمیت مدل تکمیل میشود.
مهمترین پیام کتاب این است که مزیت معاملاتی لزوماً یک مدل پیچیده یا یک سیگنال خارقالعاده نیست؛ مزیت میتواند در داشتن فرایندی منظم باشد که بتواند سیگنال واقعی را از نویز جدا کند، از بیشبرازش جلوگیری کند و زمانی که شرایط بازار تغییر میکند، استراتژی را شناسایی و اصلاح کند.
این رویکرد باعث میشود کتاب برای کسانی که میخواهند یادگیری ماشین را به شکل جدی و عملی وارد معاملهگری سیستماتیک کنند فراتر از یک کتاب صرفاً آموزشی درباره الگوریتمها باشد.

نظرات کاربران (0)