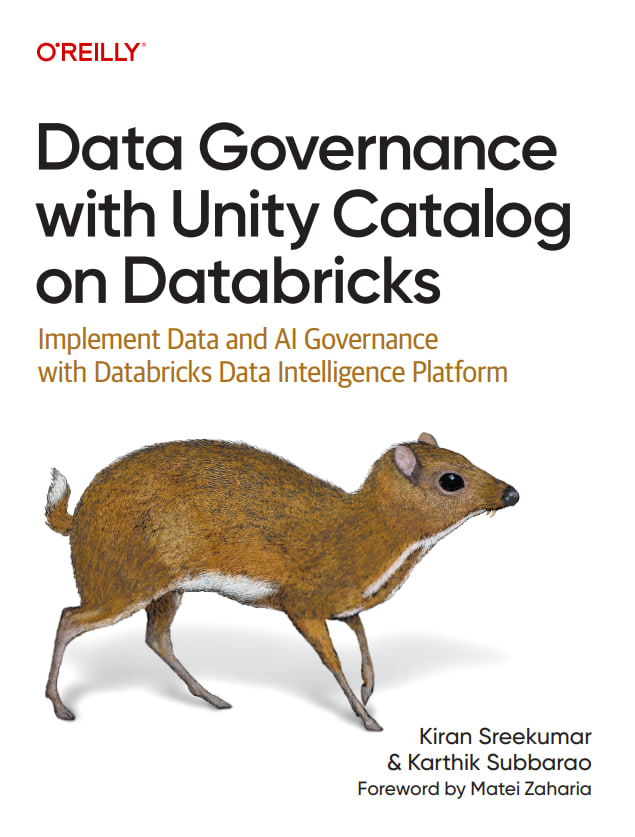
کتاب Data Governance with Unity Catalog on Databricks
کتاب Data Governance with Unity Catalog on Databricks
Implement Data and AI Governance with Databricks Data Intelligence Platform
سال چاپ: 2025
تعداد صفحات: 383
ناشر: انتشارات O'Reilly
زبان: english
نویسنده(گان): Kiran Sreekumar, Karthik Subbarao
دسته بندی: هوش مصنوعی, Machine Learning, Data Engineering
نسخه فیزیکی
نسخه الکترونیک
قیمت نهایی: 0 تومان
معرفی کتاب حاکمیت داده با Unity Catalog در Databricks (Data Governance with Unity Catalog on Databricks)
با گسترش معماریهای مدرن داده و افزایش نقش هوش مصنوعی در کسبوکارها، شیوه مدیریت و حاکمیت داده نیز در حال تغییر است. در دورهای که تحول فناوری بیشتر تحت تأثیر توسعه فرمتهای مختلف ذخیرهسازی داده قرار داشت، اکنون کاتالوگهای داده به یکی از اجزای اصلی زیرساختهای اطلاعاتی تبدیل شدهاند. سازمانها دیگر تنها به ذخیرهسازی و پردازش داده نیاز ندارند؛ بلکه باید بتوانند داراییهای دادهای و هوش مصنوعی خود را بهصورت متمرکز شناسایی، مدیریت، ایمنسازی و به اشتراک بگذارند.
کتاب Data Governance with Unity Catalog on Databricks به بررسی این تحول و نقش ابزار Unity Catalog در ایجاد یک چارچوب یکپارچه برای حاکمیت داده میپردازد. Unity Catalog که در سال ۲۰۲۱ معرفی شد، به یکی از اجزای بنیادین پلتفرم Databricks Data Intelligence تبدیل شده است. این ابزار با فراهمکردن امکان مدیریت متمرکز داراییهای داده و هوش مصنوعی، به سازمانها کمک میکند کنترل دقیقتری بر دسترسیها، امنیت، کیفیت، اشتراکگذاری و انطباق اطلاعات داشته باشند.
یکی از ویژگیهای مهم Unity Catalog، حرکت آن به سمت معماری باز و توسعهپذیر است. متن کتاب به متنبازشدن این ابزار و فرصتهایی اشاره میکند که این تغییر برای نوآوری در حوزه حاکمیت داده فراهم کرده است. APIهای باز و قابلیت یکپارچهسازی با فرمتها و ابزارهای مختلف در اکوسیستم داده و هوش مصنوعی، انعطافپذیری بیشتری در اختیار سازمانها قرار میدهند و محدودیتهای ابزارهای سنتی را کاهش میدهند.
Unity Catalog از Delta و Iceberg REST Catalog پشتیبانی میکند و امکان مدیریت مجموعه متنوعی از داراییها، از جمله جدولها، Viewها، فایلهای ذخیرهشده در فضای ابری، مدلهای هوش مصنوعی و Functionها را فراهم میسازد. به همین دلیل، این ابزار صرفاً یک کاتالوگ برای دادههای ساختاریافته نیست، بلکه بهعنوان یک کاتالوگ چندوجهی (Multimodal Catalog) شناخته میشود که تجربهای یکپارچه برای مدیریت انواع داراییهای دادهای و هوش مصنوعی ارائه میدهد.
این کتاب با هدف توضیح مفاهیم بنیادی Unity Catalog، معماری داخلی آن و روشهای پیادهسازی حاکمیت داده در محیط Databricks نوشته شده است. نویسندگان با بیش از سه سال تجربه کار نزدیک با Unity Catalog، تلاش کردهاند اصولی را که در طول تغییرات و توسعه این فناوری همچنان پایدار ماندهاند، در کنار قابلیتها و امکانات عمومی آن مستند کنند. محتوای کتاب هم به درک جهتگیری صنعت به سمت کاتالوگهای باز و متمرکز کمک میکند و هم راهنمایی عملی برای استفاده از Unity Catalog در سازمانها ارائه میدهد.
چرا حاکمیت داده با Unity Catalog اهمیت دارد؟
معماریهای داده مدرن بهسرعت در حال حرکت به سمت فناوریهای باز، قابل تعامل و مستقل از ابزارهای اختصاصی هستند. در چنین فضایی، سازمانها به راهکاری نیاز دارند که بتواند داراییهای اطلاعاتی را در یک ساختار متمرکز مدیریت کند و در عین حال امکان تعامل با ابزارها و موتورهای پردازشی مختلف را حفظ کند.
Unity Catalog با فراهمکردن یک لایه مشترک برای مدیریت داده و داراییهای هوش مصنوعی، به ایجاد چنین ساختاری کمک میکند. این رویکرد باعث میشود تیمهای مختلف سازمان بتوانند با استفاده از سیاستها و چارچوبهای مشترک به دادهها دسترسی داشته باشند، بدون آنکه مدیریت امنیت و حاکمیت به ابزار یا محیط خاصی محدود شود.
کلمات کلیدی:
نسخه فیزیکی
نسخه الکترونیک
قیمت نهایی: 0 تومان
اهمیت این موضوع بهویژه در سازمانهایی بیشتر است که چندین تیم داده، تحلیلگر، دانشمند داده و مهندس هوش مصنوعی بهصورت همزمان روی داراییهای مشترک کار میکنند. نبود یک مدل یکپارچه برای مدیریت دسترسی و مالکیت داده میتواند باعث ایجاد جزیرههای اطلاعاتی، تکرار دادهها و دشواری در نظارت بر فعالیت کاربران شود. Unity Catalog تلاش میکند این پیچیدگی را با ارائه یک مدل متمرکز برای مدیریت داراییها و مجوزها کاهش دهد.
از سوی دیگر، با افزایش استفاده از مدلهای یادگیری ماشین و سامانههای هوش مصنوعی، حاکمیت داده دیگر به جدولها و فایلها محدود نیست. مدلها، توابع و سایر داراییهای مرتبط با هوش مصنوعی نیز باید تحت کنترل و نظارت قرار گیرند. رویکرد چندوجهی Unity Catalog امکان گسترش سیاستهای حاکمیتی به این داراییها را فراهم میکند.
بررسی فصلها و مباحث اصلی کتاب
کتاب در قالب دوازده فصل، مفاهیم بنیادی حاکمیت داده، معماری Databricks، ساختار داخلی Unity Catalog و قابلیتهای آن را بررسی میکند. مسیر آموزشی کتاب از معرفی معماری مدرن حاکمیت داده آغاز میشود و سپس به مدیریت هویت، زیرساخت پردازشی، کنترل دسترسی، حاکمیت هوش مصنوعی، مشاهدهپذیری، اشتراکگذاری داده و انطباق قانونی میرسد. در فصلهای پایانی نیز موضوع مهاجرت به Unity Catalog و آینده توسعه آن بررسی میشود.
فصل اول: پشته مدرن حاکمیت داده (The Modern Governance Stack)
فصل نخست به مبانی حاکمیت داده، معماری Lakehouse و ساختار پلتفرم Databricks اختصاص دارد. در این فصل، خواننده با مفاهیمی آشنا میشود که برای درک جایگاه Unity Catalog در معماریهای مدرن داده ضروری هستند.
معماری Lakehouse با ترکیب برخی قابلیتهای مرتبط با Data Lake و Data Warehouse، بستری برای مدیریت و تحلیل داده در مقیاس سازمانی فراهم میکند. درک این معماری به شناخت بهتر نیازهای حاکمیتی و جایگاه کاتالوگ داده کمک میکند.
این فصل همچنین Unity Catalog را بهعنوان بخشی از پشته مدرن حاکمیت داده معرفی میکند و زمینه لازم را برای بررسی عمیقتر معماری و قابلیتهای آن در فصلهای بعدی فراهم میسازد.
فصل دوم: معماری داخلی Unity Catalog (Unity Catalog Under the Hood)
فصل دوم به بررسی ساختار داخلی و معماری Unity Catalog میپردازد. نویسندگان ابتدا تاریخچه مدیریت حاکمیت داده در Hive Metastore یا HMS را بررسی میکنند و توضیح میدهند که چگونه محدودیتها و نیازهای معماریهای قدیمیتر، زمینه ایجاد Unity Catalog را فراهم کردهاند.
در ادامه، معماری Unity Catalog بهصورت عمیقتری بررسی میشود تا خواننده با اجزای اصلی و نحوه عملکرد آن آشنا شود. این فصل در نهایت به مدل حاکمیتی و قابلیتهای مدیریت داده در Unity Catalog میرسد.
شناخت این بخش برای افرادی که مسئول طراحی زیرساخت داده هستند اهمیت زیادی دارد؛ زیرا درک معماری داخلی کاتالوگ به آنها کمک میکند تصمیمهای دقیقتری درباره ساختار مدیریت داراییها و پیادهسازی سیاستهای حاکمیتی اتخاذ کنند.
فصل سوم: مدیریت هویت (Identity Management)
مدیریت هویت یکی از پایههای اصلی امنیت و حاکمیت داده و هوش مصنوعی است. هر مدل کنترل دسترسی مؤثر باید بتواند هویت کاربران و سرویسها را بهدرستی تشخیص دهد و مشخص کند هر موجودیت چه مجوزهایی برای استفاده از منابع سازمانی دارد.
این فصل ابتدا ملاحظات مرتبط با مدیریت هویت در محیطهای ابری را بررسی میکند و سپس به موضوعاتی مانند تأمین و ایجاد هویتها یا Identity Provisioning، ورود یکپارچه یا Single Sign-On (SSO) و بهترین روشهای مدیریت هویت میپردازد.
مدیریت صحیح هویت به سازمان کمک میکند دسترسی کاربران و سرویسها را بر اساس سیاستهای مشخص کنترل کند و از ایجاد مجوزهای نامناسب یا دسترسیهای خارج از محدوده مسئولیت جلوگیری شود. این موضوع در محیطهایی که تیمهای متعدد به دادهها و مدلهای مشترک دسترسی دارند، اهمیت ویژهای پیدا میکند.
فصل چهارم: Unity Catalog و زیرساخت پردازشی (Unity Catalog and Compute)
فصل چهارم به ارتباط Unity Catalog با زیرساخت پردازشی Databricks میپردازد. این بخش بهویژه برای تیمهای پلتفرم اهمیت دارد؛ زیرا تغییرات ایجادشده در زیرساخت Compute بر نحوه دسترسی به دادهها و اجرای سیاستهای حاکمیتی تأثیر میگذارد.
کتاب در این فصل سه حالت اصلی دسترسی را بررسی میکند: Standard، Dedicated و Serverless. هرکدام از این حالتها ویژگیها و محدودیتهای خاص خود را دارند و شناخت تفاوت آنها برای انتخاب معماری مناسب ضروری است.
انتخاب شیوه مناسب دسترسی به منابع پردازشی باید با درنظرگرفتن نیازهای تیمهای داده، الزامات امنیتی و سیاستهای سازمان انجام شود. این فصل به خواننده کمک میکند ارتباط میان مدل پردازش و چارچوب حاکمیت داده را بهتر درک کند.
فصل پنجم: مدل کنترل دسترسی و مجوزها (Access Controls and Permissions Model)
کنترل دسترسی یکی از مهمترین اجزای حاکمیت داده است. سازمانها باید بتوانند مشخص کنند چه افرادی یا گروههایی به کدام داراییها دسترسی دارند و هر کاربر مجاز به انجام چه عملیاتی است.
در این فصل، مدل کنترل دسترسی Unity Catalog بهصورت عمیق بررسی میشود. مباحث آن شامل مدلهای مختلف حاکمیت داده، قابلیتهای موجود در سیستم مجوزدهی، طراحی ساختار Catalog و مدلسازی Permissionها است.
طراحی درست ساختار کاتالوگ و مجوزها به سازمان کمک میکند سیاستهای دسترسی را به شکلی منظم و قابل مدیریت پیادهسازی کند. این موضوع بهویژه در محیطهای سازمانی بزرگ اهمیت دارد؛ زیرا تعداد کاربران، تیمها و داراییهای دادهای میتواند بسیار زیاد باشد.
فصل ششم: حاکمیت هوش مصنوعی (Governing AI)
با افزایش استفاده از هوش مصنوعی و یادگیری ماشین در سازمانها، مدیریت و حفاظت از داراییهای AI به بخشی ضروری از حاکمیت داده تبدیل شده است. مدلهای هوش مصنوعی نیز مانند سایر داراییهای اطلاعاتی باید در طول چرخه عمر خود تحت نظارت و کنترل قرار گیرند.
فصل ششم به پارادایم جدید حاکمیت هوش مصنوعی در Unity Catalog میپردازد و چرخه عمر حاکمیت مدلهای AI را بررسی میکند. همچنین اجزای تشکیلدهنده سامانههای هوش مصنوعی و نحوه پیادهسازی آنها در چارچوب حاکمیتی مورد توجه قرار میگیرند.
این فصل برای مهندسان یادگیری ماشین و هوش مصنوعی اهمیت ویژهای دارد؛ زیرا نشان میدهد چگونه میتوان داراییهای مرتبط با AI/ML را ایمن نگه داشت و از یکپارچگی مدلها و دادههای مورد استفاده آنها محافظت کرد.
فصل هفتم: مشاهدهپذیری و کشفپذیری (Observability and Discoverability)
مدیریت مؤثر داده بدون امکان مشاهده و ارزیابی وضعیت داراییها و فرایندهای مرتبط با آنها امکانپذیر نیست. تیمهای فنی باید بتوانند وضعیت منابع داده، نحوه استفاده از آنها و عملکرد زیرساخت را بررسی کنند.
این فصل به دو مفهوم مهم Data Observability و Data Discoverability میپردازد. مشاهدهپذیری به سازمان کمک میکند وضعیت و عملکرد محیط داده را بهتر درک کند، در حالی که کشفپذیری امکان شناسایی و یافتن داراییهای اطلاعاتی موردنیاز را فراهم میسازد.
کتاب در این بخش توضیح میدهد که Unity Catalog چگونه از این قابلیتها در یک پلتفرم حاکمیتی پشتیبانی میکند. این مباحث برای تیمهای DevOps و FinOps نیز کاربرد دارند؛ زیرا نظارت بر منابع، شناخت وضعیت داراییها و مدیریت بهتر زیرساخت از نیازهای مهم این تیمهاست.
فصل هشتم: اشتراکگذاری و همکاری داده (Data Sharing and Collaboration)
یکی از اهداف اصلی پلتفرمهای داده مدرن، فراهمکردن امکان اشتراکگذاری امن اطلاعات میان تیمها و سازمانهای مختلف است. دسترسی کنترلشده به دادهها میتواند همکاری میان واحدهای سازمانی را بهبود دهد و از ایجاد نسخههای متعدد و پراکنده از اطلاعات جلوگیری کند.
فصل هشتم الگوها و بهترین روشهای اشتراکگذاری داده و داراییهای هوش مصنوعی را در داخل و خارج از سازمان بررسی میکند. یکی از موضوعات مهم این فصل، حاکمیت در سناریوهای Cross-Metastore است؛ یعنی شرایطی که دادهها و کاتالوگها در چندین Metastore مختلف مدیریت میشوند.
این بخش به خواننده کمک میکند روشهای مختلف همکاری و تبادل داراییهای اطلاعاتی را بشناسد و در عین حال کنترلهای حاکمیتی و سیاستهای دسترسی را حفظ کند.
فصل نهم: دسترسی باز (Open Access)
یکی از معیارهای مهم در انتخاب یک کاتالوگ داده، میزان سازگاری آن با ابزارها و موتورهای پردازشی خارجی است. سازمانها معمولاً نمیخواهند مدیریت دادههایشان به یک ابزار یا پلتفرم اختصاصی محدود شود؛ بلکه به راهکاری نیاز دارند که امکان تعامل با فناوریهای مختلف را فراهم کند.
فصل نهم گزینههای مختلف دسترسی باز به داده از طریق ابزارها و موتورهای خارجی را بررسی میکند. همچنین نسخه متنباز Unity Catalog و قابلیتهای مرتبط با آن مورد توجه قرار میگیرند.
این فصل با رویکرد کلی کتاب به سمت فناوریهای باز و قابل تعامل هماهنگ است و نشان میدهد چرا قابلیت اتصال به ابزارها و موتورهای مختلف میتواند در طراحی معماری داده سازمانی اهمیت داشته باشد.
فصل دهم: انطباق با استانداردهای قانونی (Being Compliant with Regulatory Standards)
سازمانهایی که اطلاعات حساس را پردازش میکنند، باید اطمینان حاصل کنند که معماری داده و سیاستهای امنیتی آنها با الزامات قانونی و مقررات مرتبط سازگار است.
فصل دهم به الزامات انطباق قانونی، از جمله General Data Protection Regulation (GDPR) میپردازد. همچنین بهترین روشهای معماری برای مدیریت و پردازش دادههای حساس بررسی میشوند.
این فصل به متخصصان کمک میکند ارتباط میان طراحی معماری داده، حفاظت از اطلاعات حساس و رعایت استانداردهای قانونی را درک کنند. توجه به این موضوع در سازمانهایی که دادههای شخصی کاربران را مدیریت میکنند یا در محیطهای چندسازمانی فعالیت دارند، اهمیت زیادی دارد.
فصل یازدهم: تسریع پذیرش Unity Catalog (Accelerating Unity Catalog Adoption)
پیادهسازی یک فناوری جدید در سازمان، تنها به شناخت قابلیتهای آن محدود نمیشود. سازمان باید بتواند زیرساخت فعلی خود را ارزیابی کند، مسیر مهاجرت را طراحی کند و فرایند انتقال را با حداقل اختلال انجام دهد.
فصل یازدهم به روشهای تسریع پذیرش Unity Catalog در سازمان میپردازد. فعالسازی خودکار Unity Catalog، فرایند مهاجرت و Federation از Hive Metastore به Unity Catalog از جمله موضوعات اصلی این بخش هستند.
این فصل برای تیمهایی که در حال استفاده از Hive Metastore هستند و قصد دارند به مدل جدید مدیریت و حاکمیت داده منتقل شوند، اهمیت ویژهای دارد. شناخت مسیر مهاجرت و قابلیتهای Federation میتواند به طراحی برنامهای منظمتر برای انتقال زیرساخت کمک کند.
فصل دوازدهم: آینده Unity Catalog (The Future of Unity Catalog)
فصل پایانی به بررسی چشمانداز آینده Unity Catalog اختصاص دارد. با توجه به تغییرات سریع در اکوسیستم داده و هوش مصنوعی، ابزارهای حاکمیتی نیز باید متناسب با نیازهای جدید توسعه پیدا کنند.
این فصل با نگاهی آیندهنگر، مسیر احتمالی توسعه Unity Catalog و قابلیتهایی را که در نقشه راه آن قرار دارند بررسی میکند. چنین دیدگاهی به معماران داده و تصمیمگیرندگان کمک میکند جایگاه این فناوری را در برنامهریزی بلندمدت سازمانی بهتر ارزیابی کنند.
این کتاب برای چه کسانی مناسب است؟
مخاطبان اصلی کتاب، متخصصان و تصمیمگیرندگانی هستند که در طراحی، پیادهسازی یا مدیریت زیرساختهای داده و هوش مصنوعی مبتنی بر Databricks فعالیت میکنند. محتوای کتاب هم جنبه معماری و راهبردی دارد و هم به جزئیات فنی پیادهسازی Unity Catalog میپردازد.
معماران داده و مدیران ارشد فناوری میتوانند از این کتاب برای شناخت روند حرکت صنعت به سمت کاتالوگهای باز، متمرکز و چندوجهی استفاده کنند. مباحث مربوط به معماری Lakehouse، تعاملپذیری و مدل حاکمیتی Unity Catalog به آنها کمک میکند تصمیمهای راهبردی آگاهانهتری درباره معماری داده و هوش مصنوعی سازمان اتخاذ کنند.
تیمهای توسعه اپلیکیشنهای داده و مهندسان داده از دیگر مخاطبان مهم کتاب هستند. افرادی که Pipelineهای ETL طراحی و پیادهسازی میکنند، پردازش داده را خودکارسازی میکنند یا اطلاعات را در اختیار تحلیلگران و دانشمندان داده قرار میدهند، میتوانند از راهنماییهای عملی کتاب برای بهبود مدیریت داده، کیفیت اطلاعات و اشتراکگذاری میان تیمها استفاده کنند.
مهندسان پلتفرم ابری که مسئول فراهمکردن زیرساخت برای تیمهای داده و اجرای استانداردهای امنیتی و حاکمیتی هستند نیز مخاطب این کتاب محسوب میشوند. مطالب مربوط به مدیریت هویت، زیرساخت Compute، کنترل دسترسی و انطباق به این متخصصان کمک میکند پلتفرمی امن و قابل اعتماد برای فعالیتهای دادهمحور سازمان ایجاد کنند.
مشاوران Databricks نیز میتوانند از توضیحات تخصصی کتاب برای افزایش تسلط خود بر Unity Catalog و ارائه راهکارهای ارزشمندتر به مشتریان استفاده کنند. همچنین مهندسان هوش مصنوعی و یادگیری ماشین با مطالعه مباحث مربوط به حاکمیت AI، مدیریت چرخه عمر مدلها و حفاظت از داراییهای هوش مصنوعی، دید بهتری نسبت به الزامات امنیت و یکپارچگی مدلها به دست میآورند.
در کنار این گروهها، متولیان داده یا Data Stewards و مدیران ارشد داده (CDOs) نیز میتوانند از مفاهیم کتاب برای شناخت چارچوب کلی حاکمیت داده و نقش Unity Catalog در رعایت استانداردهای قانونی استفاده کنند؛ هرچند تمرکز اصلی کتاب بیشتر بر جنبههای عملی و فنی این فناوری است.

نظرات کاربران (0)