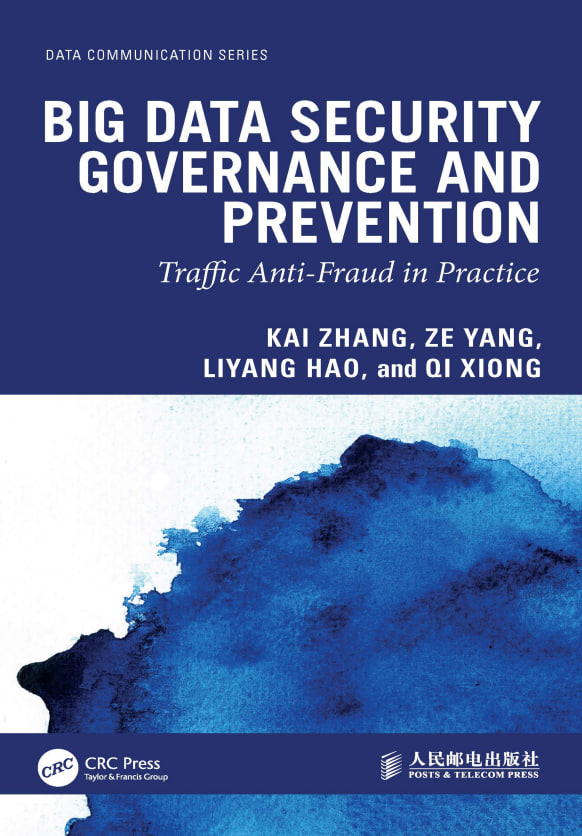
Traffic Anti‑Fraud in Practice
با گسترش خدمات آنلاین و افزایش وابستگی کسبوکارها به ترافیک اینترنت، تقلب ترافیکی به یکی از چالشهای جدی در حوزه امنیت دادههای کلان تبدیل شده است. بخش قابل توجهی از فعالیتهای مخرب در فضای دیجیتال از طریق تولید ترافیک غیرواقعی، دستکاری رفتار کاربران، سوءاستفاده از سازوکارهای تبلیغاتی و جعل هویت دستگاهها انجام میشود. شناسایی و مقابله با این تهدیدها به مجموعهای از روشهای تحلیل داده، مهندسی ویژگی، تشخیص الگوهای رفتاری و فناوریهای امنیتی نیاز دارد.
کتاب پیشگیری از تقلب ترافیکی راهنمایی کاربردی برای شناخت روشهای مهاجمان و طراحی راهکارهای فنی مقابله با تقلب در ترافیک اینترنت است. این اثر با تکیه بر تجربههای عملی تیمهای امنیتی در حوزه مقابله با تقلب، به بررسی تکنیکهای مورد استفاده در حملات واقعی و روشهای دفاع در برابر آنها میپردازد. هدف کتاب صرفا ارائه مفاهیم نظری نیست؛ بلکه تلاش میکند مبانی امنیت ترافیک را با جزئیات فنی و تجربههای اجرایی پیوند دهد تا خوانندگان بتوانند دانش خود را در پروژههای واقعی به کار بگیرند.
نویسندگان کتاب پیشتر تجربههای یک دهه فعالیت خود در حوزه فناوریهای ضدتقلب را در قالب اثری با عنوان Big Data Security Governance and Prevention: Building an Anti-Fraud System گردآوری کرده بودند. آن کتاب که در ژانویه ۲۰۲۳ منتشر شد، بهعنوان منبعی مقدماتی برای آشنایی با نظامهای امنیت دادههای کلان و مقابله با تقلب مورد استقبال قرار گرفت؛ با این حال، تمرکز آن بر مفاهیم پایه و روششناسی عمومی بود و موضوعات تخصصیتری مانند امنیت ترافیک و امنیت نشانیهای اینترنتی را بهصورت عمیق پوشش نمیداد.
کتاب حاضر با هدف پرداختن به همین حوزههای تخصصی تدوین شده است. تمرکز اصلی آن بر تقلب ترافیکی، تکنیکهای خصمانه، روشهای شناسایی رفتارهای غیرواقعی و طراحی سامانههای پیشگیری قرار دارد. به همین دلیل، علاوه بر معرفی چالشهای موجود، سازوکارهای فنی مقابله با آنها را نیز بررسی میکند.
برای طراحی یک سامانه ضدتقلب مؤثر، ابتدا باید روشهای مورد استفاده مهاجمان و تأثیر آنها بر زیرساختها و کسبوکارهای اینترنتی را شناخت. کتاب در فصل دوم به بررسی تاکتیکهای تقلب ترافیکی میپردازد و نشان میدهد فعالیتهای مخرب چگونه میتوانند دادههای ترافیکی را دستکاری کنند و بر اعتبار تحلیلها و تصمیمگیریهای مبتنی بر داده اثر بگذارند.
شناخت این روشها نقطه شروع طراحی راهکارهای دفاعی است؛ زیرا تشخیص ترافیک مخرب بدون درک رفتار مهاجمان و الگوهای عملیاتی آنها دشوار خواهد بود. این فصل زمینه لازم را برای ورود به مباحث فنیتر کتاب فراهم میکند.
یکی از مراحل اساسی در سامانههای تشخیص تقلب، آمادهسازی و مدیریت صحیح دادههاست. دادههای خام ترافیکی بهتنهایی همیشه اطلاعات کافی برای شناسایی رفتارهای مشکوک در اختیار سیستم قرار نمیدهند. ازاینرو، حاکمیت داده و مهندسی ویژگی نقش مهمی در تبدیل دادههای اولیه به اطلاعات قابل استفاده برای تحلیل و تشخیص دارند.
کلمات کلیدی:فصل سوم به حاکمیت دادههای ترافیکی و مهندسی ویژگی (Feature Engineering) اختصاص دارد. این بخش به مبانی سازماندهی دادههای ترافیکی و آمادهسازی ویژگیهای مورد نیاز برای روشهای تشخیص تقلب میپردازد؛ موضوعی که زیربنای استفاده از الگوریتمهای یادگیری ماشین و سایر سازوکارهای مقابله با رفتارهای مخرب محسوب میشود.
بخش عمده کتاب، یعنی فصلهای چهارم تا دهم، به معرفی فناوریها و روشهای فنی مقابله با تقلب اختصاص دارد. این فصلها مجموعهای از رویکردهای مکمل را بررسی میکنند که هرکدام از زاویهای متفاوت به شناسایی و مهار فعالیتهای غیرعادی کمک میکنند.
اثر انگشت دستگاه یکی از روشهای مهم برای شناسایی و تمایز دستگاههای متصل به سرویسهای اینترنتی است. فصل چهارم به فناوری Device Fingerprinting میپردازد و نقش آن را در فرایندهای شناسایی و مقابله با تقلب بررسی میکند. این فناوری به سامانههای امنیتی کمک میکند تا دستگاهها را بر اساس ویژگیهای قابل شناسایی آنها تحلیل کنند و در تشخیص فعالیتهای مشکوک از اطلاعات مربوط به دستگاه بهره ببرند.
فصل پنجم به روشهای اعتبارسنجی CAPTCHA اختصاص دارد. کپچا یکی از سازوکارهای شناختهشده برای تشخیص تعامل انسانی از فعالیتهای خودکار است. در سامانههای مقابله با تقلب ترافیکی، این روش میتواند بهعنوان یکی از لایههای دفاعی برای بررسی درخواستها و محدود کردن برخی فعالیتهای خودکار مورد استفاده قرار گیرد.
فصل ششم موتور قوانین را بهعنوان یکی دیگر از اجزای راهکارهای مقابله با تقلب بررسی میکند. موتور قوانین امکان تعریف و اجرای مجموعهای از معیارها و شرایط تشخیص را فراهم میکند. چنین سازوکاری به تیمهای امنیتی اجازه میدهد الگوهای مشخصی از رفتارهای مشکوک را شناسایی کرده و بر اساس قواعد تعریفشده به آنها واکنش نشان دهند.
فصل هفتم به یادگیری ماشین (Machine Learning) در مقابله با تقلب اختصاص دارد. با افزایش حجم و پیچیدگی دادههای ترافیکی، تکیه صرف بر قواعد ثابت ممکن است برای شناسایی تمام الگوهای مخرب کافی نباشد. روشهای یادگیری ماشین امکان تحلیل دادهها و شناسایی الگوهای پیچیدهتر را فراهم میکنند و میتوانند در کنار سایر فناوریهای امنیتی برای تشخیص رفتارهای غیرعادی به کار گرفته شوند.
فصل هشتم به روشهای مقابله خصمانه مبتنی بر شبکههای پیچیده (Complex Network Adversarial Approaches) میپردازد. این رویکرد با بررسی ارتباطات و روابط میان اجزای مختلف یک شبکه، امکان تحلیل الگوهای پیچیده رفتاری را فراهم میکند. توجه به ساختار ارتباطی و روابط میان موجودیتها میتواند در شناسایی الگوهایی مؤثر باشد که بررسی جداگانه هر درخواست یا دستگاه لزوما آنها را آشکار نمیکند.
در فصل نهم، راهکارهای یکپارچه مقابله با تقلب چندوجهی (Multimodal Integrated Countermeasure Scheme) بررسی میشوند. رویکرد چندوجهی بر استفاده همزمان از انواع مختلف اطلاعات و نشانهها برای تحلیل دقیقتر رفتار ترافیکی تکیه دارد. ترکیب چند روش تشخیص میتواند تصویر جامعتری از فعالیتهای مشکوک ایجاد کند و وابستگی سامانه به یک معیار یا فناوری واحد را کاهش دهد.
فصل دهم به رویکردهای جدید مقابله با تقلب اختصاص دارد. این فصل در ادامه مباحث فنی قبلی، به روشهای نوین و رویکردهای تکمیلی در مواجهه با تهدیدهای ترافیکی میپردازد؛ حوزهای که با تغییر مداوم تکنیکهای مهاجمان، نیازمند توسعه و بهروزرسانی مستمر راهکارهای امنیتی است.
تشخیص تقلب تنها به انتخاب الگوریتم یا پیادهسازی ابزارهای فنی محدود نمیشود. یک سامانه ضدتقلب برای اثربخشی در محیط واقعی به چارچوب عملیاتی مشخصی نیاز دارد؛ چارچوبی که بتواند فناوریها، فرایندها و دانش حاصل از تجربههای امنیتی را در کنار یکدیگر قرار دهد.
فصل یازدهم به چارچوب عملیاتی (Operational Framework) اختصاص دارد و به جنبههای اجرایی استقرار و مدیریت راهکارهای مقابله با تقلب میپردازد. این بخش نشان میدهد که چگونه میتوان فناوریهای معرفیشده در فصلهای پیشین را در قالب یک رویکرد عملیاتی منسجم به کار گرفت.
فصل پایانی نیز بر استخراج و کاربرد هوشمندی دانش (Knowledge Intelligence Mining and Application) تمرکز دارد. هدف این حوزه، بهرهگیری از دانش و اطلاعات موجود برای شناسایی الگوها و استفاده مؤثرتر از تجربههای بهدستآمده در مقابله با تقلب است. چنین رویکردی میتواند به تبدیل دادهها و تجربههای پراکنده به دانشی قابل استفاده در تصمیمگیریهای امنیتی کمک کند.
این کتاب در دوازده فصل تنظیم شده است و خواننده را از شناخت تحولات ترافیک اینترنت و چالشهای تقلب در عصر دادههای کلان، به سمت فناوریهای تخصصی مقابله با تهدیدها هدایت میکند. ساختار آن بهگونهای است که ابتدا مفاهیم و روشهای تقلب معرفی میشوند، سپس مبانی مدیریت داده و فناوریهای تشخیص مورد بررسی قرار میگیرند و در نهایت مباحث عملیاتی و هوشمندی دانش مطرح میشوند.
این ترتیب به متخصصان امنیت، مهندسان داده و توسعهدهندگان سامانههای ضدتقلب کمک میکند تا ارتباط میان دادههای ترافیکی، روشهای تحلیل، فناوریهای دفاعی و فرایندهای عملیاتی را بهتر درک کنند.
کتاب پیشگیری از تقلب ترافیکی منبعی کاربردی برای مهندسان امنیت سایبری، متخصصان امنیت دادههای کلان، مهندسان داده، تحلیلگران ترافیک اینترنت و توسعهدهندگان سامانههای ضدتقلب است. افرادی که در زمینه شناسایی ترافیک غیرواقعی، تحلیل رفتار کاربران، مقابله با فعالیتهای خودکار مخرب و طراحی زیرساختهای امنیتی فعالیت میکنند، میتوانند از مباحث این اثر بهره ببرند.
همچنین برای پژوهشگران و دانشجویان حوزه امنیت اطلاعات و دادههای کلان که به دنبال شناخت روشهای فنی مقابله با تقلب ترافیکی هستند، این کتاب میتواند مسیر مناسبی برای آشنایی با فناوریهایی مانند اثرانگشتگیری دستگاه، کپچا، موتورهای قوانین، یادگیری ماشین و تحلیل شبکههای پیچیده فراهم کند.
امنیت سایبری و امنیت اطلاعات، امنیت دادههای کلان، مهندسی داده، یادگیری ماشین
نمونه چاپ کتاب موجود نیست.
نظرات کاربران (0)